

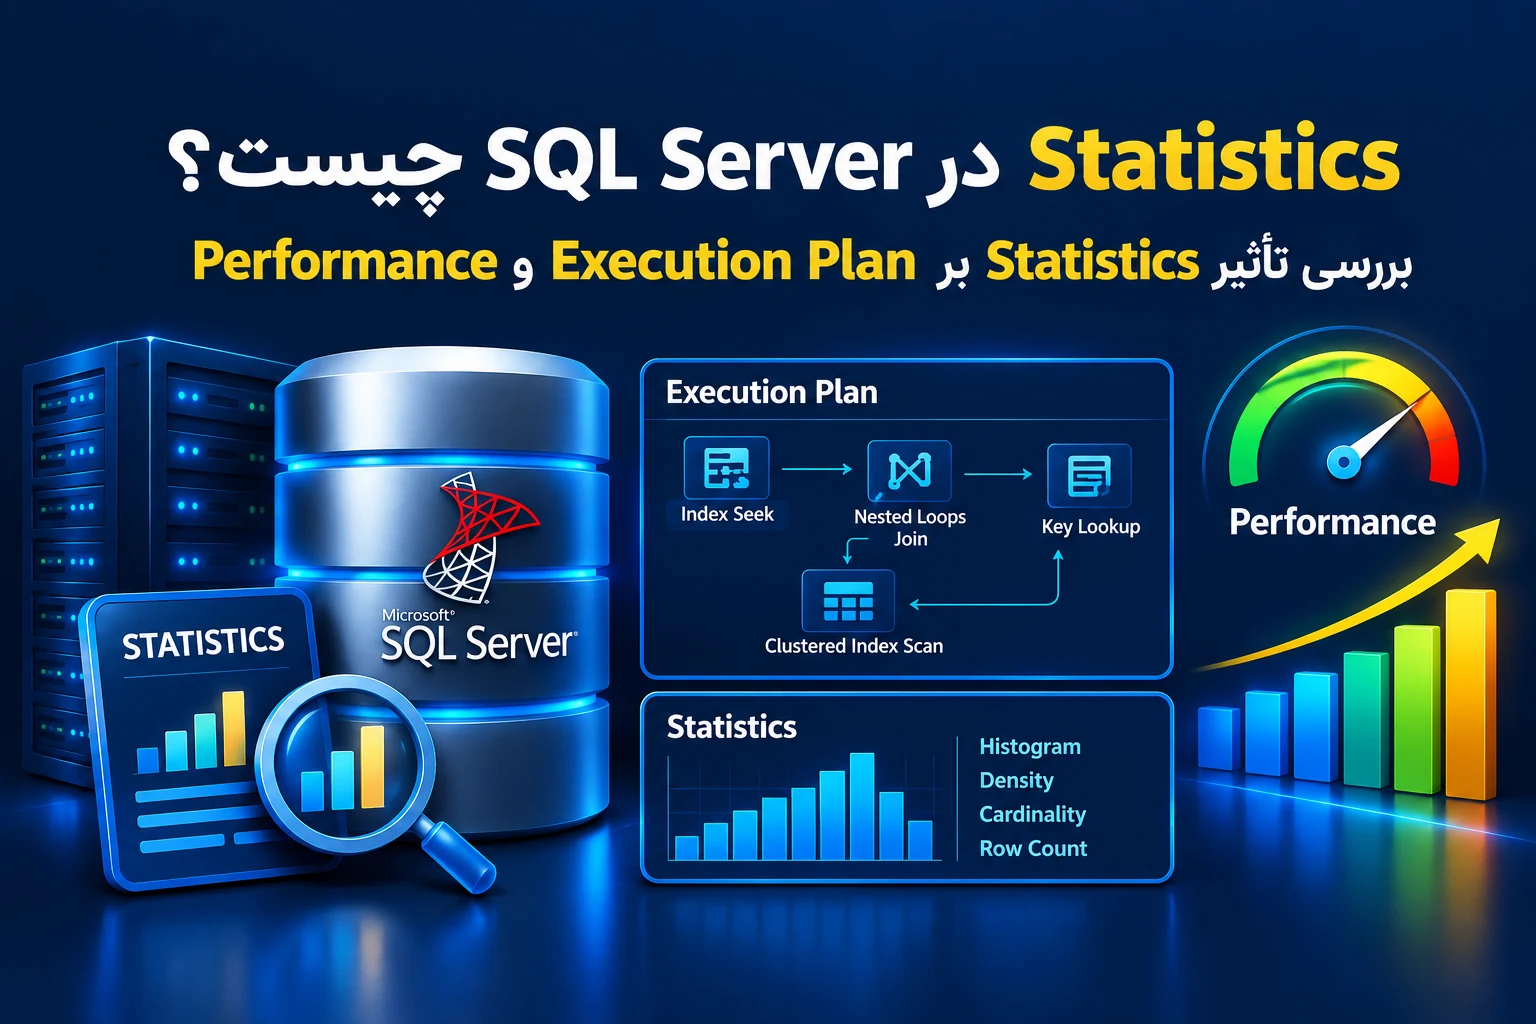
Statistics در SQL Server چیست و چرا اهمیت دارد ؟
اگر در SQL Server با Queryهای کند، Execution Planهای غیرمنتظره یا اختلاف زیاد بین Estimated Rows و Actual Rows مواجه شدهاید، یکی از اولین مواردی که باید بررسی کنید Statistics است. SQL Server قبل از اجرای Query باید تصمیم بگیرد دادهها را چگونه از جدول دریافت کند، چه Indexای را استفاده کند، ترتیب Joinها چگونه باشد و از چه Operatorهایی در Execution Plan استفاده شود. اما Query Optimizer قبل از اجرای Query تعداد واقعی ردیفهایی را که قرار است پردازش شوند نمیداند. اینجاست که Statistics اهمیت پیدا میکند. Statistics اطلاعاتی درباره Data Distribution در اختیار Query Optimizer قرار میدهد تا بتواند تعداد ردیفهای مورد انتظار را تخمین بزند و بر اساس این تخمین، Execution Plan مناسبتری انتخاب کند.
به زبان ساده:
Statistics به SQL Server کمک میکند قبل از اجرای Query، درباره حجم دادهای که باید پردازش شود، یک تخمین داشته باشد. هرچه این تخمین به واقعیت نزدیکتر باشد، احتمال انتخاب Execution Plan مناسب بیشتر است.
رابطه Statistics، Cardinality و Execution Plan
سه مفهوم زیر ارتباط بسیار نزدیکی با یکدیگر دارند:
Statistics → Cardinality Estimate → Execution Plan
Query Optimizer از Statistics برای تخمین تعداد ردیفها استفاده میکند. این فرآیند با عنوان Cardinality Estimation شناخته میشود. سپس بر اساس این تخمین، هزینه روشهای مختلف اجرای Query را محاسبه کرده و Execution Plan را انتخاب میکند.
برای مثال فرض کنید Query زیر را داریم:
SELECT *
FROM dbo.Customer
WHERE CustomerID = 100;
اگر SQL Server بر اساس Statistics تخمین بزند که فقط یک ردیف برگردانده میشود، استفاده از یک Index Seek میتواند انتخاب مناسبی باشد. اما اگر Statistics نشان دهد که تعداد بسیار زیادی ردیف دارای این مقدار هستند، استفاده از Index ممکن است دیگر بهترین انتخاب نباشد و SQL Server به سراغ Scan برود. بنابراین وجود Index بهتنهایی تضمین نمیکند که SQL Server از آن استفاده کند. Statistics نیز در این تصمیم نقش مهمی دارد.
Statistics چگونه باعث تغییر Execution Plan میشود؟
یکی از نکات مهم در SQL Server این است که با تغییر Data Distribution، انتخاب Execution Plan نیز میتواند تغییر کند. فرض کنید ابتدا فقط یک ردیف مقدار 2 داشته باشد:
SELECT *
FROM dbo.Test1
WHERE C1 = 2;
در چنین شرایطی Index Seek انتخاب مناسبی است. اما اگر بعداً تعداد زیادی ردیف با مقدار 2 وارد جدول شوند، Selectivity این مقدار کاهش پیدا میکند. در نتیجه مراجعه به Index و سپس دسترسی به تعداد زیادی ردیف از جدول میتواند پرهزینهتر از یک Scan باشد. اگر Statistics بهروز باشد، Query Optimizer این تغییر در Data Distribution را تشخیص میدهد و میتواند Execution Plan جدیدی انتخاب کند. در نمونه ، بعد از افزایش تعداد ردیفها، Execution Plan از تعداد زیادی Seek به یک Table Scan تغییر کرد. این دقیقاً یکی از دلایلی است که Statistics را باید بخشی از فرآیند SQL Server Performance Tuning بدانیم.
Statistics قدیمی چه مشکلی ایجاد میکند؟
یکی از رایجترین مشکلات Performance در SQL Server، Out-of-Date Statistics است. فرض کنید Statistics میگوید Query شما تقریباً دو ردیف برمیگرداند، در حالی که در واقعیت 1,501 ردیف باید پردازش شود. در این شرایط Query Optimizer ممکن است Execution Plan را بر اساس همان دو ردیف انتخاب کند.
نتیجه میتواند افزایش:
1. Logical Reads
2. CPU
3. Duration
4. I/O
5. Memory Consumption
و در نهایت کاهش Performance باشد.
در آزمایش ، یک Query با Statistics بهروز حدود 11 Logical Read و 44.2 ms زمان اجرا داشت، در حالی که با Statistics قدیمی تعداد Reads به 1,510 و میانگین Duration به 63.6 ms رسید. بنابراین وقتی یک Query ناگهان کند شده است، فقط Indexها را بررسی نکنید؛ Statistics را نیز بررسی کنید.
چگونه SQL Server Statistics را بهصورت خودکار بهروز میکند؟
SQL Server بهصورت پیشفرض Statistics را مدیریت میکند. اما دو قابلیت بسیار مهم در این زمینه عبارتاند از:
AUTO_CREATE_STATISTICS
AUTO_UPDATE_STATISTICS
AUTO_CREATE_STATISTICS باعث میشود SQL Server در شرایط مناسب برای ستونهایی که Index ندارند Statistics ایجاد کند.
AUTO_UPDATE_STATISTICS نیز مسئول بهروزرسانی Statisticsهای موجود در صورت تغییر کافی دادهها است.
در بیشتر سیستمها بهتر است این قابلیتها فعال باقی بمانند؛ مگر اینکه با Testing و شواهد مشخص، دلیل فنی برای تغییر آنها داشته باشید.
چگونه وضعیت Auto Create Statistics را بررسی کنیم؟
میتوانید وضعیت AUTO_CREATE_STATISTICS را با DATABASEPROPERTYEX بررسی کنید:
SELECT DATABASEPROPERTYEX (
'AdventureWorks',
'IsAutoCreateStatistics'
);
اگر مقدار 1 باشد، ایجاد خودکار Statistics فعال است.
برای فعال کردن آن:
ALTER DATABASE AdventureWorks SET AUTO_CREATE_STATISTICS ON;
این قابلیت مخصوصاً برای ستونهایی اهمیت دارد که در WHERE، JOIN یا HAVING استفاده میشوند اما عضو Index نیستند.
آیا ستون بدون Index هم Statistics دارد؟
بله.
این یکی از نکات مهم Statistics در SQL Server است.
ممکن است ستونی هیچ Indexای نداشته باشد اما در Query زیر استفاده شود:
SELECT * FROM dbo.Customer WHERE City = 'London';
SQL Server میتواند برای City یک Statistics ایجاد کند تا Query Optimizer بتواند Data Distribution آن را بهتر تخمین بزند. Statistics ایجادشده بهصورت خودکار معمولاً نامی مشابه زیر دارند:
_WA_Sys_...
وجود این Statistics به Query Optimizer اجازه میدهد حتی بدون وجود Index، تخمینهای بهتری برای Filter و Join داشته باشد.
چگونه Statisticsهای یک جدول را مشاهده کنیم؟
برای مشاهده Statisticsهای یک جدول میتوانید از sys.stats استفاده کنید:
SELECT
s.name,
s.auto_created,
s.user_created
FROM sys.stats AS s
WHERE object_id = OBJECT_ID('dbo.Test1');
برای بررسی اینکه Statistics مربوط به چه ستونهایی هستند، میتوانید sys.stats_columns و sys.columns را نیز Join کنید:
SELECT
s.name,
s.auto_created,
s.user_created,
sc.column_id,
c.name AS ColumnName
FROM sys.stats AS s
JOIN sys.stats_columns AS sc
ON sc.stats_id = s.stats_id
AND sc.object_id = s.object_id
JOIN sys.columns AS c
ON c.column_id = sc.column_id
AND c.object_id = s.object_id
WHERE s.object_id = OBJECT_ID('dbo.Test1');
این روش برای بررسی Statistics موجود روی یک جدول بسیار کاربردی است.
DBCC SHOW_STATISTICS چیست؟
یکی از مهمترین ابزارهای DBA برای تحلیل Statistics، دستورDBCC SHOW_STATISTICS است.برای مثال:
DBCC SHOW_STATISTICS ( 'dbo.Test1', 'FirstIndex' );
خروجی این دستور شامل سه بخش اصلی است:
1. Header
2. Density
3. Histogram
Header در Statistics چه اطلاعاتی دارد؟
Header اطلاعات کلی Statistics را نمایش میدهد. برخی اطلاعات مهم آن عبارتاند از:
1. Name
2. Updated
3. Rows
4. Rows Sampled
5. Steps
6. Density
برای مثال Rows تعداد ردیفهای جدول در زمان ایجاد یا Update شدن Statistics را نشان میدهد و Rows Sampled تعداد ردیفهایی را نشان میدهد که برای ایجاد Statistics نمونهبرداری شدهاند. بنابراین هنگام بررسی Statistics، Header یکی از اولین قسمتهایی است که باید بررسی شود.
Density در SQL Server چیست؟
Density معیاری برای Selectivity دادهها است. برای Statistics تکستونه، مفهوم پایه آن به شکل زیر است:
Density = 1 / Number of Distinct Values
بنابراین هرچه تعداد مقادیر متمایز بیشتر باشد، Density کمتر خواهد بود . مثلاً اگر ستونی 1,000 مقدار متمایز داشته باشد:
Density = 1 / 1000 = 0.001
Density کمتر معمولاً نشاندهنده Selectivity بیشتر است و چنین ستونی میتواند برای Index Key گزینه مناسبی باشد.
Histogram چیست؟
Histogram یکی از مهمترین بخشهای Statistics در SQL Server است. Histogram نحوه توزیع دادهها را برای اولین ستون Statistics نمایش میدهد و میتواند حداکثر 200 Step داشته باشد. مهمترین ستونهای Histogram عبارتاند از:
RANGE_HI_KEY : حد بالای Range
EQ_ROWS : تعداد ردیفهای برابر با مقدار Range
RANGE_ROWS : تعداد ردیفهای بین دو Range
DISTINCT_RANGE_ROWS : تعداد مقادیر متمایز در Range
AVG_RANGE_ROWS : میانگین تعداد ردیف برای هر مقدار احتمالی
برای مثال اگر Query مقدار 827 را جستوجو کند و نزدیکترین RANGE_HI_KEY بزرگتر از آن 831 باشد، Query Optimizer میتواند از اطلاعات Histogram برای تخمین تعداد ردیفهای مورد انتظار استفاده کند.
Cardinality Estimation چیست؟
Cardinality Estimation فرآیندی است که SQL Server از طریق آن تعداد ردیفهای مورد انتظار در بخشهای مختلف Execution Plan را تخمین میزند.
این تخمین بر اساس اطلاعاتی مانند:
1. Histogram
2. Density
3. Selectivity
4. Statistics
5. Data Distribution
انجام میشود.
یکی از مهمترین مواردی که هنگام بررسی Execution Plan باید به آن توجه کنید، اختلاف بین:
Estimated Number of Rows
Actual Number of Rows
است.
اگر این دو مقدار اختلاف بسیار زیادی داشته باشند، Statistics و Cardinality Estimation از اولین مواردی هستند که باید بررسی شوند.
Statistics چندستونه یا Multicolumn Statistics چیست؟
در یک Statistics تکستونه، Histogram بر اساس همان ستون ساخته میشود. اما در یک Compound Key مانند:
CREATE NONCLUSTERED INDEX IX_Test ON dbo.Test1 ( C1, C2 );
Statistics اطلاعات Density مربوط به ترکیب ستونها را نیز در اختیار Query Optimizer قرار میدهد. نکته بسیار مهم این است که Histogram فقط برای اولین یا Leading Column ایجاد میشود. بنابراین ترتیب ستونها در یک Multicolumn Index اهمیت زیادی دارد.
آیا SQL Server برای دو ستون در WHERE یک Multicolumn Statistics میسازد؟
خیر، این یک اشتباه رایج است. فرض کنید Query زیر را داریم:
SELECT
p.Name,
p.Class
FROM Production.Product AS p
WHERE p.Color = 'Red' AND p.DaysToManufacture > 15;
SQL Server بهصورت Automatic Statistics Creation برای هر ستون Statistics جداگانه ایجاد میکند؛ نه یک Multicolumn Statistics. برای ایجاد اطلاعات Density چندستونه، میتوان از Compound Index یا Statistics دستی استفاده کرد.
Filtered Statistics و Filtered Index چه کاربردی دارند؟
Filtered Index فقط بخشی از دادهها را در Index نگهداری میکند.
برای مثال:
CREATE INDEX IX_Test ON Sales.SalesOrderHeader ( PurchaseOrderNumber ) WHERE PurchaseOrderNumber IS NOT NULL;
در این حالت Statistics مربوط به Index نیز بر اساس مجموعه داده فیلترشده ایجاد میشود. در نتیجه Histogram و Density فقط Data Distribution مربوط به همان بخش از داده را منعکس میکنند. این موضوع میتواند در شرایطی که فقط بخش خاصی از دادهها برای Queryهای شما اهمیت دارد، بسیار مفید باشد.
Auto Update Statistics یا Asynchronous Statistics Update؟
در حالت عادی، اگر SQL Server تشخیص دهد Statistics نیاز به Update دارد، Query ممکن است منتظر انجام عملیات Update بماند.
در حالت:
AUTO_UPDATE_STATISTICS_ASYNC = ON
Query اجرای خود را با Statistics موجود ادامه میدهد و Update Statistics در پسزمینه انجام میشود. در اجرای Queryهای بعدی، Statistics بهروز در دسترس خواهد بود. این قابلیت میتواند در محیطهایی که تأخیر ناشی از Update Statistics مشکلساز است مفید باشد؛ اما باید توجه داشت که Query فعلی ممکن است همچنان با Statistics قدیمی اجرا شود. بنابراین فعال کردن آن باید بر اساس رفتار واقعی Workload و Testing انجام شود.
چگونه Statistics را با Extended Events بررسی کنیم؟
اگر میخواهید بفهمید SQL Server چه زمانی Statistics را Update یا Create میکند، Extended Events ابزار بسیار مناسبی است.
یکی از Eventهای مهم:
sqlserver.auto_stats
است.
برای مثال:
CREATE EVENT SESSION [Statistics]
ON SERVER
ADD EVENT sqlserver.auto_stats
( ACTION
(
sqlserver.sql_text
)
WHERE
(
sqlserver.database_name = N'AdventureWorks'
)
),
ADD EVENT sqlserver.sql_batch_completed
(
WHERE
(
sqlserver.database_name = N'AdventureWorks'
)
);
GO
ALTER EVENT SESSION [Statistics]
ON SERVER
STATE = START;
با این روش میتوانید فرآیند Auto Statistics را مشاهده و بررسی کنید. برای بررسی عمیقتر Cardinality Estimation نیز Event دیگری با نام:
query_optimizer_estimate_cardinality
وجود دارد که میتواند اطلاعات بیشتری درباره نحوه محاسبه Estimateها ارائه کند. این Event در Debug Channel قرار دارد و استفاده از آن باید با احتیاط و ترجیحاً در محیط غیر Production انجام شود.
هنگام کند شدن Query، Statistics را چگونه بررسی کنیم؟
اگر یک Query ناگهان کند شده است، این ترتیب بررسی میتواند بسیار مفید باشد:
1. Execution Plan را بررسی کنید
به اختلاف بین این دو مقدار توجه کنید:
Estimated Rows
Actual Rows
اگر اختلاف بسیار زیاد است، Statistics یکی از مظنونهای اصلی است.
2. وضعیت Statistics را بررسی کنید
SELECT
s.name,
s.auto_created,
s.user_created
FROM sys.stats AS s
WHERE s.object_id = OBJECT_ID('dbo.YourTable')
3. Statistics موردنظر را با SHOW_STATISTICS بررسی کنید
DBCC SHOW_STATISTICS ( 'dbo.YourTable', 'StatisticsName' );
سپس موارد زیر را بررسی کنید:
Updated Rows Rows Sampled Steps Density Histogram
4. بررسی کنید Auto Update فعال باشد
SELECT DATABASEPROPERTYEX ( 'YourDatabase', 'IsAutoUpdateStatistics' );
5. Data Distribution را بررسی کنید
اگر دادهها بهشدت تغییر کردهاند یا Data Skew وجود دارد، Statistics ممکن است دیگر توزیع واقعی دادهها را بهخوبی نشان ندهد.
6. در صورت نیاز Extended Events را بررسی کنید
بهخصوص:
auto_stats missing_column_statistics query_optimizer_estimate_cardinality
این Eventها میتوانند در پیدا کردن علت Estimateهای نامناسب بسیار کمککننده باشند.
آیا باید Auto Update Statistics را خاموش کنیم؟
در اغلب سیستمها خیر.
خاموش کردن AUTO_UPDATE_STATISTICS بدون داشتن یک Statistics Maintenance مناسب میتواند باعث Out-of-Date Statistics و در نتیجه Execution Plan نامناسب شود. اگر این قابلیت را غیرفعال میکنید، باید یک فرآیند جایگزین برای نگهداری Statistics داشته باشید. به همین دلیل، قبل از غیرفعال کردن آن باید با Testing مشخص شود که این تغییر واقعاً برای Workload شما مزیت دارد.
جمعبندی
Statistics یکی از اجزای مهم Query Optimization در SQL Server است و نقش آن فقط به Indexها محدود نمیشود.
Statistics به Query Optimizer کمک میکند:
1. تعداد ردیفهای مورد انتظار را تخمین بزند.
2. Selectivity را ارزیابی کند.
3. Join مناسبتری انتخاب کند.
4. بین Seek و Scan تصمیم بگیرد.
5. Execution Plan مناسبتری ایجاد کند.
6. هزینه اجرای روشهای مختلف را تخمین بزند.
از طرف دیگر، Statistics قدیمی یا Statistics ناقص میتواند باعث Cardinality Estimate اشتباه و در نهایت Execution Plan نامناسب شود. به همین دلیل، هنگام Performance گاهی مشکل اصلی Query این نیست که Index ندارد؛ بلکه این است که Query Optimizer تصویر درستی از دادههای شما ندارد. Tuning یک Query، فقط به Indexها نگاه نکنید. و این دقیقاً جایی است که Statistics اهمیت خود را نشان میدهد.
💬 نظرات (0)
هنوز نظری ثبت نشده است. اولین نفری باشید که نظر میدهید!
📝 ثبت نظر جدید